
Cloudflare Basin startet als serverlose Datenplattform
Cloudflare hat seine bisherige Data Platform in Basin umbenannt und allgemein verfügbar gemacht. Die Plattform bündelt das Einlesen, Speichern und Abfragen großer Datenmengen. Unternehmen sollen dafür keine eigenen Datenbankcluster bereitstellen oder verwalten müssen.
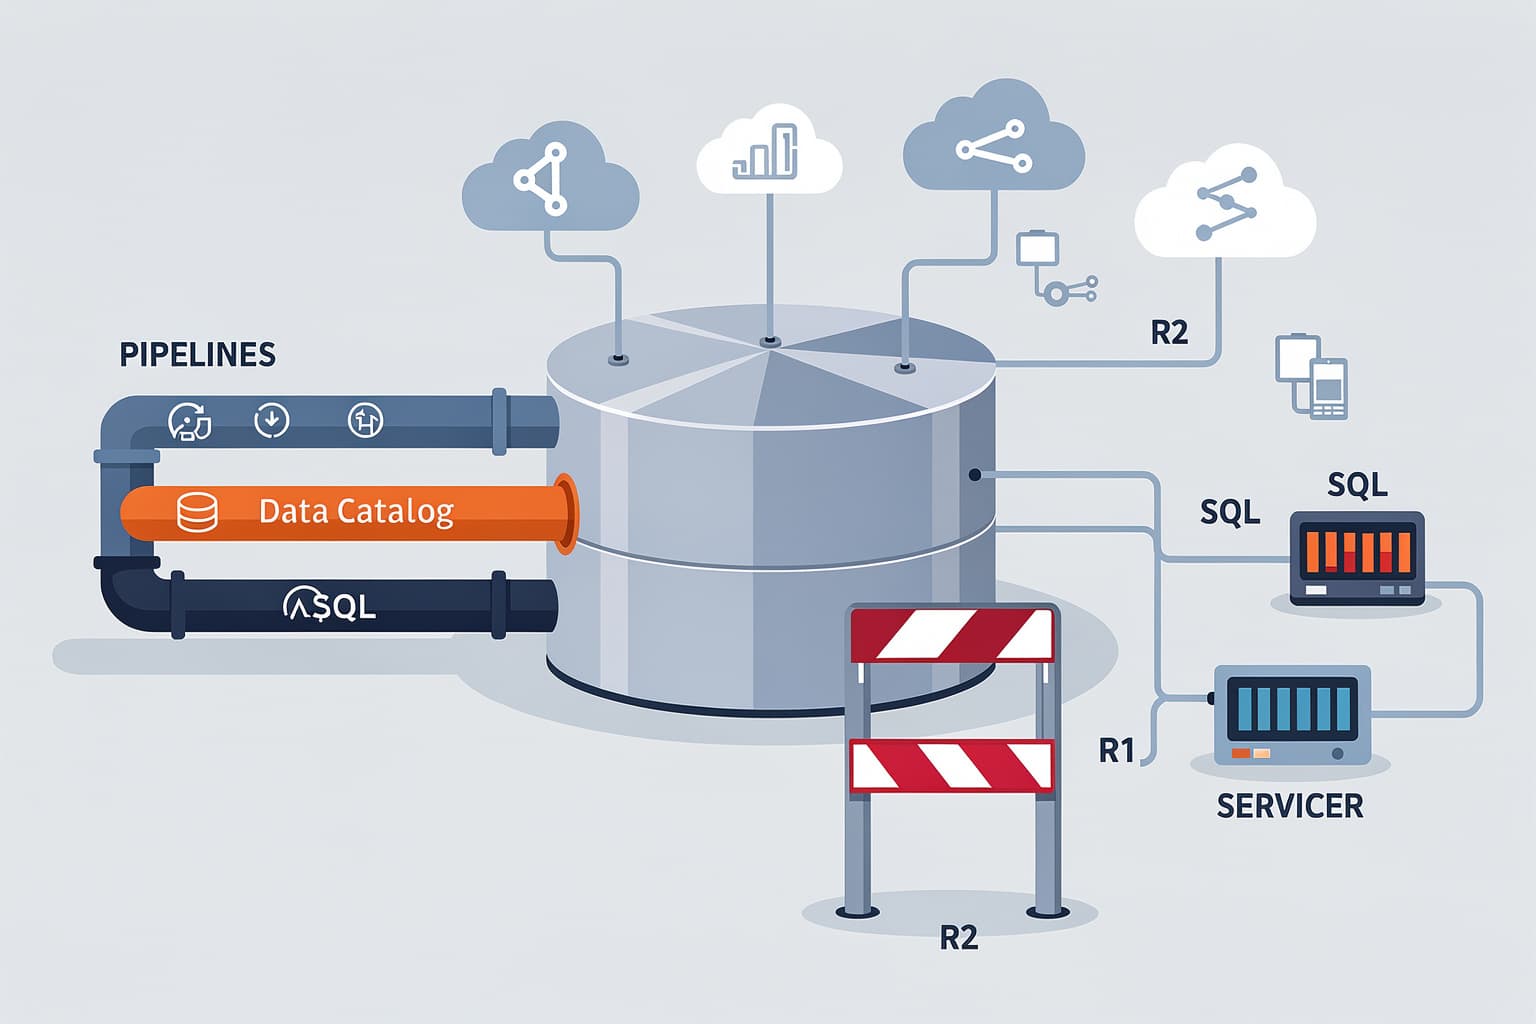
Mit der Umbenennung erhalten auch die einzelnen Dienste neue Namen. Cloudflare Pipelines wird zu Basin Pipelines, R2 Data Catalog zu Basin Catalog und R2 SQL zu Basin SQL.
| Komponente | Aufgabe | Kostenrelevanter Punkt |
|---|---|---|
| Basin Pipelines | Übernimmt kontinuierliche Datenströme und schreibt sie in R2 | Nach dem enthaltenen Kontingent fallen Gebühren für ausgelieferte Daten an |
| Basin Catalog | Verwaltet Tabellen und Metadaten auf Basis von Apache Iceberg | Speicher und angebundene Dienste werden getrennt abgerechnet |
| Basin SQL | Fragt die gespeicherten Daten per SQL ab | Abfragekosten hängen von der Nutzung des Dienstes ab |
| Cloudflare R2 | Speichert Objekte und Tabellendaten | Direkter ausgehender Datenverkehr verursacht laut Cloudflare keine Transfergebühren |
Apache Iceberg soll den Lock-in begrenzen
Technische Grundlage ist Apache Iceberg, ein offenes Tabellenformat für große analytische Datenbestände. Es trennt die gespeicherten Dateien von der Abfrage- und Verarbeitungsschicht. Dadurch können verschiedene Werkzeuge auf dieselben Daten zugreifen, ohne sie vorher in ein proprietäres Format umzuwandeln.
Neben Basin SQL unterstützt das Konzept externe Abfragewerkzeuge wie DuckDB, PyIceberg, Snowflake, Spark, StarRocks und Trino. Damit unterscheidet sich Basin von geschlossenen Analyseplattformen, bei denen Speicherung, Katalog und Rechenleistung eng an einen Anbieter gekoppelt sind.
„Mit Cloudflare Basin übertragen wir das serverlose Modell auf analytische Daten. Es sind keine Cluster zu verwalten, unnötige Datenbewegungen entfallen und offene Standards halten die Kontrolle über die Daten beim Kunden.“
Sinngemäße Übersetzung einer Aussage von Cloudflare-CTO Dane Knecht.
Offene Formate beseitigen den Vendor-Lock-in allerdings nicht vollständig. Betrieb, Zugriffssteuerung, Abrechnung und Verfügbarkeit bleiben vom Cloudflare-Dienst abhängig. Der wesentliche Vorteil besteht darin, dass die Daten bei einem späteren Wechsel nicht erst aus einem proprietären Datenmodell herausgelöst werden müssen.
Keine Egress-Gebühren gilt nur für den direkten Weg
Cloudflare stellt vor allem die entfallenden Egress-Gebühren heraus. Direkte Datenübertragungen aus R2 über die Workers API, die S3 API oder r2.dev sollen keine zusätzlichen Transferkosten verursachen. Abfragen aus anderen Regionen oder Cloud-Plattformen können dadurch günstiger werden als bei Anbietern, die jedes ausgehende Gigabyte berechnen.
Die Aussage gilt jedoch nicht für die gesamte Verarbeitungskette. Werden kostenpflichtige Cloudflare-Dienste oder externe Plattformen mit einem R2-Bucket verbunden, können diese Dienste eigene Nutzungs- und Transfergebühren berechnen. Auch Basin Pipelines besitzt nach dem enthaltenen Kontingent eine Kostenposition, die Cloudflare selbst als „Sinks (egress)“ bezeichnet.
Für eine belastbare Kalkulation reicht deshalb der Blick auf den R2-Datentransfer nicht aus. Relevant sind zusätzlich Datenaufnahme, Abfragen, externe Rechenleistung und die Gebühren angebundener Analysewerkzeuge. Gerade bei kontinuierlichen Datenströmen kann die Pipeline-Nutzung einen erheblichen Teil der Gesamtkosten ausmachen.
Alternative zu integrierten Hyperscaler-Angeboten
Basin positioniert sich zwischen reinem Objektspeicher und vollständig integrierten Data-Warehouse-Angeboten. Die Daten bleiben in einem offenen Format im Objektspeicher, während Abfragen mit unterschiedlichen Systemen möglich sind. Einen vergleichbaren Trend zeigt AWS Aurora mit direkten SQL-Abfragen auf S3-Daten, allerdings innerhalb des AWS-Ökosystems.
Cloudflare verbindet Basin zudem mit seiner eigenen Compute-Plattform. Anwendungen und Datenverarbeitung lassen sich etwa über Workers ergänzen. Dazu passen die inzwischen allgemein verfügbaren Cloudflare Python Workers, mit denen sich Python-Code näher an gespeicherten Daten ausführen lässt.
Was Basin für Unternehmen im DACH-Raum bedeutet
Für datenintensive Anwendungen kann der Wegfall direkter Egress-Gebühren die Cloud-Kosten planbarer machen. Das betrifft etwa Analyseplattformen, Protokolldaten und KI-Pipelines, die dieselben Daten aus mehreren Regionen oder über verschiedene Werkzeuge hinweg verarbeiten.
Datenschutz und Datensouveränität werden durch ein offenes Dateiformat allein jedoch nicht gelöst. Vor einem produktiven Einsatz müssen Speicherorte, Auftragsverarbeitung, Löschkonzepte, Zugriffsrechte und die Verarbeitung durch externe Abfragedienste geprüft werden. Apache Iceberg erleichtert die technische Portabilität, ersetzt aber keine rechtliche und organisatorische Kontrolle.
Basin ist damit vor allem für Unternehmen interessant, die eine verwaltete Plattform nutzen möchten, ohne ihre analytischen Daten vollständig an ein proprietäres System zu binden. Wer maximale Kontrolle oder Self-Hosting benötigt, kann dieselben offenen Formate auch mit eigenen Iceberg-kompatiblen Komponenten betreiben. Dafür steigt allerdings der Aufwand für Betrieb, Skalierung und Überwachung.