Google erweitert Gemini um paralleles Sprach-Reasoning
Google hat am 15. September 2026 zwei neue Modelle für dialogbasierte KI vorgestellt. Gemini 3.8 Live ist auf Skalierbarkeit und Kosteneffizienz ausgelegt. Gemini 3.8 Live Extended Thinking soll komplexe Aufgaben mit mehrstufigem Reasoning bearbeiten.
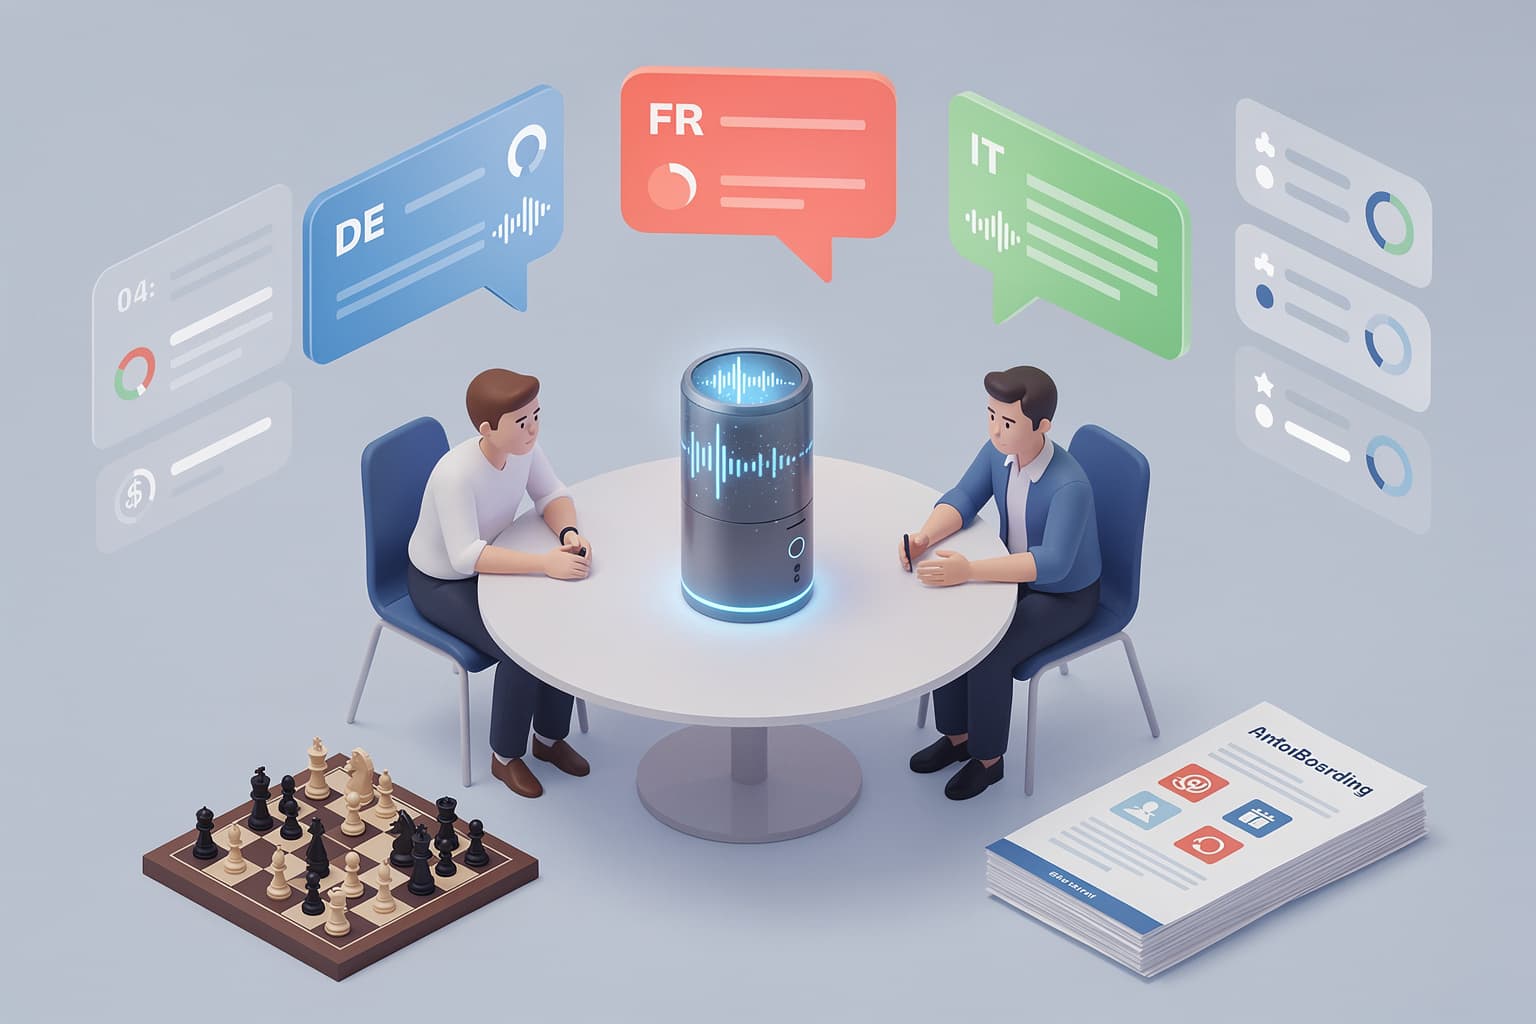
Beide Modelle können während eines laufenden Gesprächs Werkzeuge und APIs aufrufen. Die Sprachinteraktion muss dafür nicht pausieren. Das unterscheidet die Systeme von Sprachassistenten, die Anfragen erst vollständig verarbeiten und anschließend antworten.
| Modell | Schwerpunkt | Geeignete Aufgaben |
|---|---|---|
| Gemini 3.8 Live | Skalierbarkeit und Kosteneffizienz | Sprachdialoge, visuelle Kontexte und Hintergrundaktionen |
| Gemini 3.8 Live Extended Thinking | Komplexes, mehrstufiges Reasoning | Umfangreiche Arbeitsabläufe und koordinierte API-Aufrufe |
Werkzeuge laufen im Hintergrund weiter
Gemini 3.8 Live Extended Thinking kann gleichzeitig sprechen und weitere Rechenschritte ausführen. Während Hintergrundprozesse laufen, bestätigt das Modell die Anfrage mit Formulierungen wie sinngemäß „Ich prüfe das“ und kommentiert den Fortschritt. Damit sollen längere Wartephasen weniger abrupt wirken.
Dieser Ansatz ist vor allem für Sprachagenten relevant, die mehrere Systeme koordinieren. Denkbar sind etwa Abfragen von Kundendaten, mehrstufige Buchungen oder die Bearbeitung interner Arbeitsabläufe. Vergleichbare Grundlagen für solche Anwendungen bietet auch die OpenAI Agents API.
Die eigentliche Neuerung liegt nicht nur in der Sprachausgabe. Entscheidend ist, dass Dialog, Reasoning und Werkzeugaufrufe parallel ablaufen können.
Visuelle Eingaben und 97 Sprachen
Die Modelle verarbeiten visuelle Informationen nahezu in Echtzeit. Als mögliche Eingaben nennt Google unter anderem Skizzen, Schachbretter und Materialien für die Einarbeitung neuer Beschäftigter. Die visuelle Kontextverarbeitung verknüpft dabei das aktuelle Bild mit dem laufenden Gespräch.
Unterstützt werden 97 Sprachen. Das System soll die verwendete Sprache automatisch erkennen und mitten im Gespräch wechseln können. Für Kundenservice in der Schweiz oder für länderübergreifende Support-Hotlines im DACH-Raum kann diese Funktion den Betrieb mehrsprachiger Sprachagenten vereinfachen.
Alle von den Modellen erzeugten Audiosignale erhalten ein nicht hörbares SynthID-Wasserzeichen. Damit soll sich KI-generiertes Audiomaterial technisch erkennen lassen.
Extended Thinking führt die genannten Benchmarks an
Google nennt mehrere Messwerte für Gemini 3.8 Live Extended Thinking. Die Ergebnisse beziehen sich auf unterschiedliche Tests für Sprachqualität, agentische Aufgabenerfüllung und Audio-Reasoning. Sie sind deshalb nicht direkt miteinander vergleichbar.
| Benchmark | Ergebnis | Einordnung |
|---|---|---|
| Artificial Analysis Speech to Speech Quality Index | 82,6 Punkte | Platz 1 |
| τ-Voice | 68,6 % | Erfolgsquote bei agentischen Sprachaufgaben |
| Sierras τ-Voice-banking | 35,1 % | Erfolgsquote bei Banking-Aufgaben |
| Big Bench Audio | 97,7 % | Audio-Reasoning |
| Gemini 3.8 Live in der Speech Agent Arena | Platz 2 | Nutzerpräferenz |
Auch OpenAI arbeitet an natürlich wirkenden Sprachschnittstellen. GPT-Live-1 mit Full-Duplex-API verfolgt ebenfalls das Ziel, gleichzeitiges Sprechen und Zuhören technisch abzubilden.
Eigene Sprachagenten statt starrer Telefonie-SaaS
Die Gemini Live API wird von Frameworks und Plattformen wie LangChain, LiveKit, Pipecat, Agora, Fishjam, Vercel und Vision Agents unterstützt. Diese Werkzeuge übernehmen Teile der Echtzeitübertragung und erleichtern die Entwicklung eigener Sprachoberflächen.
Für Unternehmen eröffnet das eine Alternative zu starren Sprachmenüs und spezialisierten Callcenter-Abos. Ein eigener Agent kann gezielt mit bestehenden Prozessen und internen APIs verbunden werden. Dafür fallen jedoch Entwicklungs-, Integrations- und Betriebsaufwand an.
Vollständig unabhängig ist dieser Ansatz nicht. Die Modelle werden über Googles API genutzt, eine Self-Hosting-Option für eigene Server wird nicht angeboten. Damit verlagert sich die Abhängigkeit von einer fertigen Telefonie-SaaS auf die Modell- und Cloud-Infrastruktur von Google.
Preise und Datenschutz bleiben offen
Entwickler erhalten ab sofort Zugriff über die Gemini API und Google AI Studio. Unternehmenskunden können die Modelle zunächst als Private Preview über Gemini Enterprise einsetzen. Einen Termin für die allgemeine Verfügbarkeit nennt Google nicht.
Konkrete API-Preise pro Minute oder Token liegen ebenfalls nicht vor. Aussagen zur Kosteneffizienz lassen sich deshalb noch nicht belastbar mit bestehenden Telefonieplattformen oder anderen Sprachmodellen vergleichen.
| Unternehmensfrage | Aktueller Stand |
|---|---|
| API-Preis pro Minute oder Token | Nicht beziffert |
| Self-Hosting | Nicht verfügbar |
| DSGVO-Konformität der Sprach- und Bildverarbeitung | Keine konkreten Angaben |
| Rechenzentrumsstandorte in der EU | Keine konkreten Angaben |
| Allgemeine Verfügbarkeit für Unternehmen | Kein Termin genannt |
Gerade im Kundenservice werden Sprachaufnahmen, Bilddaten und möglicherweise personenbezogene Informationen verarbeitet. Vor einem produktiven Einsatz im DACH-Raum müssen deshalb Datenflüsse, Speicherfristen, Auftragsverarbeitung und Zugriffsrechte geklärt werden. Die technische Leistungsfähigkeit ersetzt diese Prüfung nicht.