Stromproblem legt Google-Cloud-Dienste in London lahm
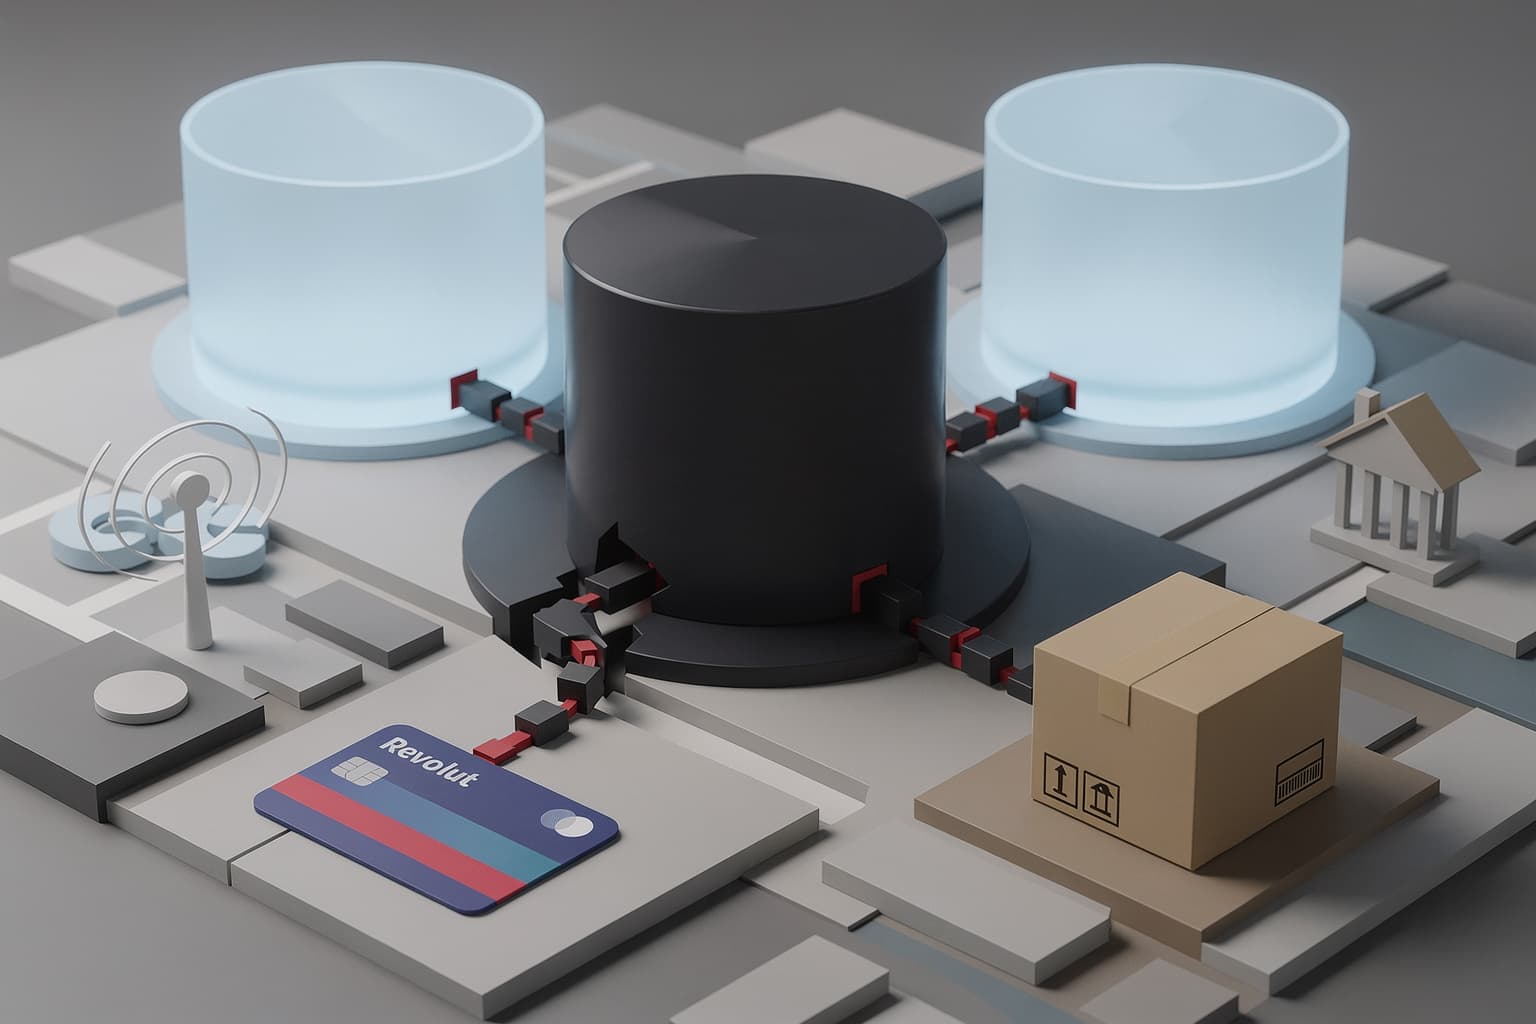
Ein mehrstündiger Ausfall in der Google-Cloud-Region London hat zahlreiche digitale Dienste beeinträchtigt. Betroffen war vor allem die Verfügbarkeitszone europe-west2-b, eine von drei lokalen Zonen der Region europe-west2.
Google nennt ein Problem mit der Stromversorgung als Ursache. Technische Details dazu, welche Komponenten konkret ausgefallen sind, veröffentlichte das Unternehmen bislang nicht.
Bei mehreren Google-Cloud-Diensten treten in der Region europe-west2 vermehrt Fehler und zeitweise Netzwerkausfälle auf, erklärte Google auf seiner Statusseite.
Revolut, HSBC, DPD und weitere Anbieter betroffen
Die Störung begann am Dienstagmorgen gegen 08:00 Uhr MESZ. Zu den betroffenen Unternehmen gehörten die Neobank Revolut, Lloyds Bank, HSBC, Royal Mail, DPD, British Telecom, Rightmove, Cloudflare und der Händler Screwfix.
Die Auswirkungen waren nicht auf Großbritannien begrenzt. Auch deutsche Kunden von Revolut konnten Bankdienste zeitweise nicht wie gewohnt nutzen. Ein paralleler Ausfall bei ING stand nach Angaben der Bank dagegen nicht mit der Google-Cloud-Störung in Verbindung.
| Unternehmen oder Bereich | Gemeldete Beeinträchtigung |
|---|---|
| Revolut | Bankdienste, auch für Kunden in Deutschland |
| Lloyds Bank und HSBC | Digitale Bankdienste |
| Royal Mail und DPD | Logistikdienste |
| BT, Rightmove und Screwfix | Digitale Angebote und Plattformen |
| Google SecOps | Cloudnative Sicherheitsanalyse und Automatisierung |
Zentrale Plattformdienste fielen gleichzeitig aus
Die Störung erfasste nicht nur einzelne virtuelle Maschinen. Mehrere verwaltete Plattformdienste waren gleichzeitig beeinträchtigt. Dazu gehörten Google Kubernetes Engine, Cloud Run, Google App Engine und verschiedene Daten-, Speicher- und Messaging-Dienste.
| Betroffener Google-Cloud-Dienst | Typische Aufgabe |
|---|---|
| Google Kubernetes Engine | Betrieb containerisierter Anwendungen |
| Cloud Run | Ausführung verwalteter Container |
| Google App Engine | Bereitstellung von Webanwendungen |
| BigQuery Data Transfer Service | Automatisierte Datenübertragung nach BigQuery |
| Cloud Filestore und NetApp Volumes | Verwalteter Dateispeicher |
| Managed Service for Apache Kafka | Verarbeitung von Datenströmen |
Auch Google SecOps war gestört. Die Plattform verbindet SIEM zur zentralen Auswertung von Sicherheitsereignissen mit SOAR zur automatisierten Reaktion auf Vorfälle. Gerade während eines Infrastrukturausfalls kann die eingeschränkte Verfügbarkeit solcher Sicherheitswerkzeuge zusätzliche operative Risiken verursachen.
Wiederherstellung dauerte mehrere Stunden
Nachdem Google das Problem mit der Stromversorgung behoben hatte, liefen die Infrastrukturdienste schrittweise wieder an. Google SecOps war laut Statusseite ab 13:50 Uhr MESZ wieder verfügbar. Die vollständige Wiederherstellung bestehender Workloads wurde bis 15:00 Uhr MESZ erwartet, während das Anlegen neuer Workloads zeitweise weiter eingeschränkt sein konnte.
| Zeitpunkt | Status |
|---|---|
| Gegen 08:00 Uhr MESZ | Beginn der Störung |
| 13:50 Uhr MESZ | Google SecOps wiederhergestellt |
| Bis 15:00 Uhr MESZ | Vollständige Wiederherstellung bestehender Workloads erwartet |
Als vorübergehende Maßnahme empfahl Google, betroffene Arbeitslasten in eine andere Zone oder Region zu verlagern. Ob und in welchem Umfang einzelne Unternehmen bereits Multi-Zone-Architekturen eingesetzt hatten, ist nicht bekannt. Ebenso gibt es keine belastbaren Angaben zur finanziellen Schadenshöhe.
Eine Cloud-Zone kann eine ganze Lieferkette treffen
Der Vorfall verdeutlicht die Abhängigkeiten hinter modernen SaaS-Angeboten. Fällt eine zentrale Cloud-Zone aus, betrifft das nicht nur den direkten Cloud-Kunden. Auch Banken, Paketdienste und deren Endkunden können Teil desselben Kaskadeneffekts werden.
Für Unternehmen im DACH-Raum reicht es deshalb nicht, auf die formale Aufteilung eines Hyperscalers in mehrere Zonen zu vertrauen. Anwendungen müssen tatsächlich so konzipiert sein, dass sie ohne manuelle Eingriffe in einer anderen Zone oder Region weiterlaufen können. Dazu gehören replizierte Daten, getestete Wiederanlaufverfahren und möglichst wenige zonengebundene Abhängigkeiten.
Die Diskussion um europäische Cloud-Souveränität erhält durch solche Ausfälle eine praktische Dimension. Dabei geht es nicht nur um den Standort von Daten, sondern auch um die Frage, wie stark kritische Prozesse von einem einzelnen US-Anbieter abhängen.
Multi-Cloud und Self-Hosting sind keine kostenlosen Versicherungen
Eine Multi-Cloud-Strategie kann Ausfallrisiken verteilen, erhöht aber Architektur-, Betriebs- und Testaufwand. Self-Hosting reduziert die direkte Abhängigkeit von einem Hyperscaler, verlagert Verantwortung und Kosten jedoch in das eigene Unternehmen. Beide Ansätze sind nur dann belastbar, wenn Umschaltverfahren regelmäßig geprüft werden.
Auch regulatorische und organisatorische Anforderungen können gegen eine vollständige Cloud-Zentralisierung sprechen. Der gestoppte Microsoft-365-Cloud-Umzug einer niederländischen Steuerbehörde zeigt, dass Abhängigkeit, Kontrolle und Datensouveränität inzwischen gemeinsam bewertet werden.
Für geschäftskritische Anwendungen sollte deshalb dokumentiert sein, welche Prozesse an eine bestimmte Zone, Region oder einen Anbieter gebunden sind. Erst diese Übersicht macht sichtbar, ob ein einzelnes Stromproblem ausreicht, um zentrale Geschäftsabläufe und nachgelagerte SaaS-Dienste gleichzeitig zu stoppen.