Jev ersetzt Textausgaben durch Zahlen
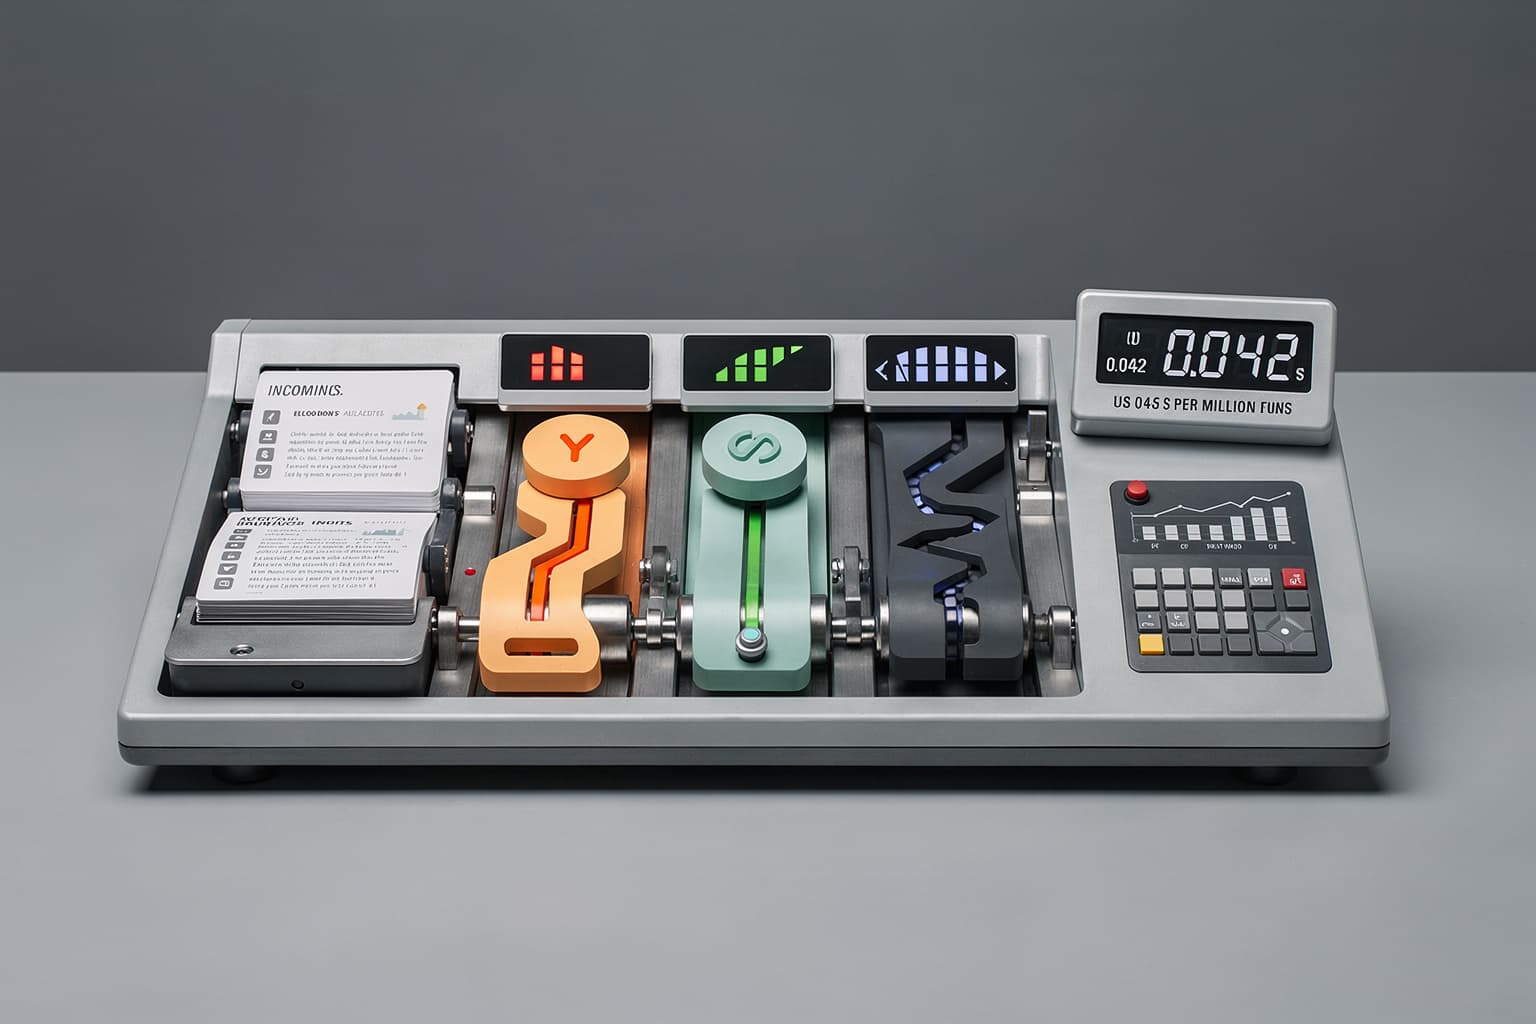
TypeSafe AI hat mit Jev ein Modell vorgestellt, das nicht wie ein klassisches Large Language Model antwortet. Statt Fließtext liefert es ausschließlich typisierte Gleitkommazahlen für Klassifizierungen, Bewertungen und Wahrscheinlichkeiten.
Das Unternehmen bezeichnet diese Kategorie als System One Model. Treffender ist der Begriff Entscheidungsmodell, denn Jev soll keine Inhalte formulieren, sondern aus unstrukturierten oder teilweise strukturierten Daten eine numerische Entscheidung ableiten.
TypeSafe AI beschreibt Jev sinngemäß als einen Funktionsaufruf mit hoher Modellleistung: Unstrukturierter Zustand hinein, typisierte probabilistische Entscheidungen heraus.
Als Eingabe akzeptiert Jev Texte, Listen und Name-Wert-Paare. Angaben zur zugrunde liegenden Architektur, zu den Trainingsdaten und zur exakten Größe des Kontextfensters macht TypeSafe AI bislang nicht.
Drei Fragetypen für Klassifizierung und Bewertung
Jev unterstützt drei fest definierte Arten von Fragen. Die Antworten lassen sich direkt in Anwendungen, Regeln oder automatisierte Arbeitsabläufe übernehmen, ohne zunächst eine natürlichsprachliche Ausgabe auswerten zu müssen.
| Fragetyp | Funktionsweise | Typische Anwendung |
|---|---|---|
| Noul | Liefert für eine Ja-Nein-Aussage einen Wert zwischen 0 und 1. Der Name leitet sich von der Bernoulli-Verteilung ab. | Spam-Erkennung, Freigaben, Risikoprüfung |
| Choice | Wählt aus vorgegebenen Optionen und liefert zusätzlich eine Wahrscheinlichkeitsverteilung. | Labels, Routing, Kategorisierung |
| Score | Ordnet den Inhalt auf einer beschriebenen numerischen Skala ein. | Priorisierung, Relevanzbewertung, Ranking |
Mehrere Fragen zu einem Dokument werden innerhalb des verfügbaren Kontextfensters parallel verarbeitet. Dadurch soll die Bearbeitung vieler Fragen ähnlich schnell erfolgen wie die Auswertung einer einzelnen Frage. Wie viele Fragen in der Praxis gleichzeitig möglich sind, hängt vom nicht näher bezifferten Kontextfenster ab.
Nur Input-Tokens werden berechnet
Das auffälligste Merkmal ist das Preismodell. TypeSafe AI berechnet ausschließlich die Eingabe. Die numerische Ausgabe ist kostenlos.
| Modell | Preis pro 1 Million Tokens | Abrechnung der Ausgabe |
|---|---|---|
| Jev | 0,042 US-Dollar für Input-Tokens | Kostenlos |
| GPT-5 Nano | 0,05 US-Dollar | Nicht Bestandteil des Jev-Preismodells |
Der Vergleich zeigt, wie günstig spezialisierte Inferenz werden kann. Für Unternehmen ist allerdings nicht nur der Tokenpreis relevant. Entwicklung, Qualitätssicherung, Überwachung und die Einbindung in bestehende Prozesse verursachen weiterhin Aufwand.
Besonders interessant ist der Ansatz für Aufgaben, bei denen generierter Text keinen Mehrwert liefert. Wer lediglich wissen muss, in welche Warteschlange ein Vorgang gehört oder wie relevant ein Suchergebnis ist, benötigt keine ausführliche Antwort eines universellen Sprachmodells.
Einsatz in Suche, Routing und Priorisierung
Zu den naheliegenden Anwendungen zählen Spam-Filter, Label-Vorschläge, Ticket-Priorisierung und das Routing von Anfragen. Jev kann außerdem Ergebnisse eines klassischen Suchverfahrens wie BM25 neu sortieren. Dabei trifft BM25 zunächst eine kostengünstige Vorauswahl, anschließend bewertet das Entscheidungsmodell die Relevanz der Kandidaten.
Dieses Vorgehen passt zu einer Architektur, in der nicht jede Aufgabe an das größte verfügbare Modell geschickt wird. Wie stark ein solches Modell-Routing den Tokenverbrauch reduzieren kann, zeigt sich bereits bei anderen KI-Anwendungen.
Für Unternehmen kann das den Bedarf an separaten Klassifizierungs-, Moderations- oder Triage-Abonnements reduzieren. Eine schmale eigene Anwendung mit klarer Entscheidungslogik ist oft leichter kontrollierbar als mehrere spezialisierte SaaS-Dienste mit jeweils eigenen Preisen und Schnittstellen.
Die Zahl erklärt ihre Herkunft nicht
Die kompakte Ausgabe hat einen erheblichen Nachteil. Jev nennt keine textliche Begründung und zeigt nicht, welche Signale zu einer Einstufung geführt haben. Das verstärkt den Black-Box-Charakter des Modells.
Bei einer Spam-Klassifizierung mag eine Wahrscheinlichkeit ausreichen. Bei Bewerberauswahl, Kreditvergabe oder anderen sensiblen Entscheidungen wird die fehlende Nachvollziehbarkeit dagegen zum Risiko. Verzerrungen lassen sich schwer untersuchen, wenn das System nur einen Zahlenwert zurückgibt.
Für Unternehmen im DACH-Raum sind deshalb belastbare Testdatensätze, dokumentierte Schwellenwerte und eine laufende Überwachung erforderlich. Je nach Einsatzgebiet müssen außerdem Vorgaben der DSGVO und des EU AI Act berücksichtigt werden. Ob die API von TypeSafe AI selbst DSGVO-konform betrieben werden kann, lässt sich derzeit nicht beurteilen, da Angaben zu Hosting-Standorten und Rechenzentrumssicherheit fehlen.
Open-Weight-Nachbauten entstehen bereits
Die Open-Source-Community arbeitet bereits an Nachbauten. Kev basiert auf Qwen 3.5 und wird in Varianten mit 0,8 Milliarden, 4 Milliarden und 9 Milliarden Parametern entwickelt. Mit JevBench ist zudem ein Vergleichsbenchmark für diese Modellklasse entstanden.
| Kev-Variante | Parameter |
|---|---|
| Kev 0.8B | 0,8 Milliarden |
| Kev 4B | 4 Milliarden |
| Kev 9B | 9 Milliarden |
Solche offenen Varianten schaffen grundsätzlich die Möglichkeit, Klassifizierungen lokal oder im eigenen Rechenzentrum auszuführen. Sie sind jedoch nicht automatisch funktional gleichwertig mit Jev. Qualität, Geschwindigkeit und Verzerrungen müssen für den jeweiligen Anwendungsfall separat geprüft werden.
Der wirtschaftliche Trend ist dennoch klar. Open-Weight-Modelle können deutlich günstiger betrieben werden und reduzieren die Bindung an eine proprietäre API. Für wiederkehrende, klar abgegrenzte Entscheidungen kann eine selbst betriebene Lösung damit attraktiver werden als ein dauerhaftes SaaS-Abonnement.
Entscheidungsmodelle brauchen strengere Tests
Jev zeigt eine sinnvolle Abkehr vom Prinzip, jede KI-Aufgabe als Chat zu behandeln. Numerische Ausgaben sind günstiger, leichter maschinell weiterzuverarbeiten und für viele interne Prozesse ausreichend.
Gerade weil das Ergebnis so einfach aussieht, darf es nicht ungeprüft als objektive Wahrheit behandelt werden. Vor einem produktiven Einsatz sind systematische Tests mit realen Grenzfällen, unterschiedlichen Personengruppen und bekannten Fehlerszenarien nötig. Der niedrige Tokenpreis macht umfangreiche Testläufe erschwinglich, ersetzt aber keine fachliche Kontrolle.