Ein Signal für mehrere KI-Anbieter
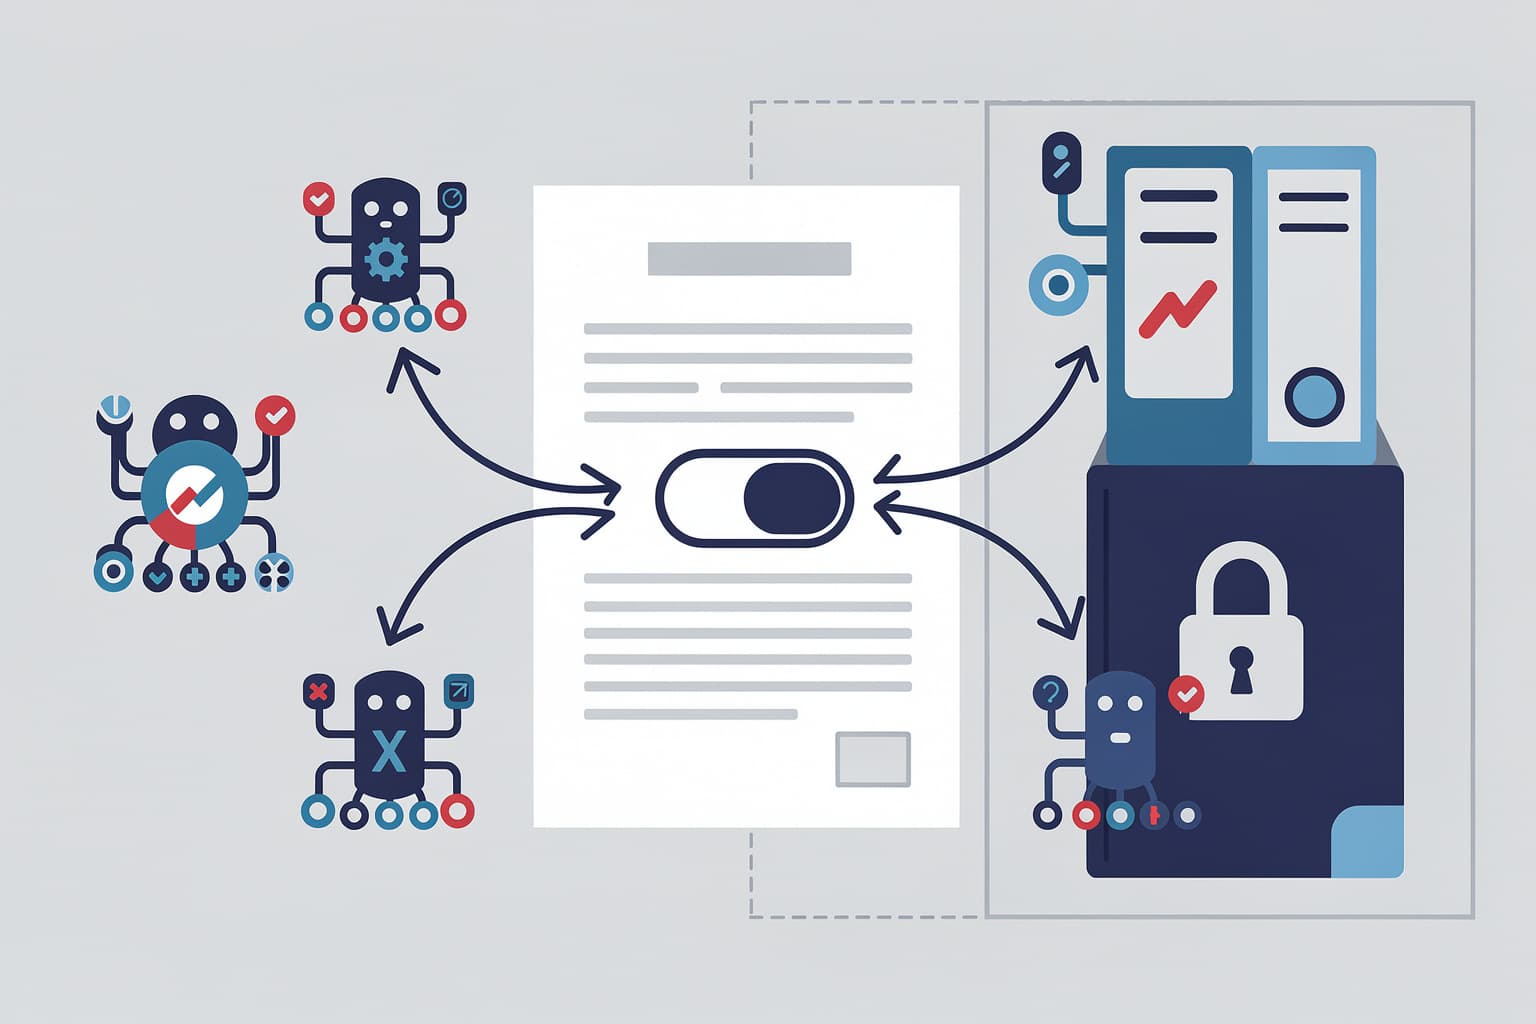
OpenAI hat am 30. Oktober 2026 angekündigt, ein gemeinsames Signal in der robots.txt-Datei zu respektieren. Damit sollen Website-Betreiber festlegen können, ob ihre Inhalte für das Training generativer Basismodelle verwendet werden dürfen.
Die robots.txt ist eine maschinenlesbare Datei im Stammverzeichnis einer Website. Sie enthält Hinweise dazu, welche Bereiche automatisierte Crawler abrufen dürfen. Bislang mussten Betreiber die Crawler einzelner KI-Anbieter identifizieren und jeweils eigene Regeln pflegen.
Sinngemäß erklärt OpenAI, dass ein gemeinsames Signal für mehrere teilnehmende Anbieter den Verwaltungsaufwand reduziert und Website-Betreibern eine einfachere Kontrolle über die Verwendung ihrer Inhalte gibt.
Was sich für Website-Betreiber ändert
Die Grundlage bildet die Arbeit der AI Preferences Working Group innerhalb der Internet Engineering Task Force, kurz IETF. Die IETF entwickelt offene technische Standards für das Internet. OpenAI will das Signal in den kommenden Monaten implementieren und später weitere Einzelheiten veröffentlichen.
| Aspekt | Bisherige Steuerung | Gemeinsames Signal |
|---|---|---|
| Verwaltung | Separate Regeln für einzelne Crawler | Eine Präferenz für mehrere teilnehmende Anbieter |
| Bestehende Regeln | Anbieterspezifische robots.txt-Einträge | Bleiben weiterhin gültig |
| Verbindlichkeit | Abhängig vom jeweiligen Crawler | Freiwillige Unterstützung durch Anbieter |
| Technische Syntax | Je nach Anbieter unterschiedlich | Noch nicht veröffentlicht |
Das neue Signal ersetzt die vorhandenen Crawler-Regeln von OpenAI nicht. Betreiber können diese weiterhin nutzen, wenn einzelne Seiten oder Verzeichnisse differenziert behandelt werden sollen.
Bislang ist außerdem nicht bestätigt, welche weiteren KI-Anbieter das Signal unterstützen werden. OpenAI ruft andere Unternehmen zur Teilnahme auf, eine verbindliche Liste gibt es jedoch noch nicht.
robots.txt ist keine Zugriffssperre
Die Standardisierung erleichtert die Kommunikation einer Präferenz, verhindert technisch aber keinen Zugriff. Ein Crawler kann robots.txt ignorieren. Die Zusage von OpenAI ist daher zunächst eine freiwillige Selbstverpflichtung und keine Zugriffskontrolle.
Auch die rechtliche Durchsetzbarkeit des neuen Signals ist noch offen. Im europäischen Urheberrecht können Vorbehalte gegen Text und Data Mining relevant sein. Ob und unter welchen Bedingungen das IETF-Signal dafür ausreicht, lässt sich aus der Ankündigung nicht ableiten.
Die grundsätzliche Auseinandersetzung um das Auslesen öffentlich erreichbarer Inhalte bleibt damit bestehen. Das zeigen auch die Diskussionen um Metas geplantes Scraping von Websites seiner Geschäftskunden und die veränderte Scraping-Klausel von Meta.
Praktische Folgen für Unternehmen im DACH-Raum
Für Verlage, Softwareanbieter und Unternehmen mit umfangreichen Wissensportalen kann ein einheitliches Signal den laufenden Pflegeaufwand senken. Neue KI-Crawler müssten nicht mehr zwangsläufig über eigene User-Agents erkannt und separat eingetragen werden, sofern deren Betreiber den Standard unterstützen.
Für sensible Inhalte reicht das nicht aus. Internes Know-how, Quellcode, Dokumentationen und Kundendaten sollten hinter Authentifizierung und echten Berechtigungsprüfungen liegen. Protokollierung, Zugriffslimits und eine klare Trennung zwischen öffentlichen und internen Inhalten bleiben notwendig.
Wer interne Daten für KI-Anwendungen nutzen möchte, kann zusätzlich selbst gehostete Modelle oder kontrollierte Infrastruktur einsetzen. Das reduziert die Abhängigkeit von externen Plattformen und erleichtert die Kontrolle darüber, welche Informationen an einen Anbieter übertragen werden. Das neue robots.txt-Signal löst dieses Problem nicht, macht aber die Verwaltung öffentlich zugänglicher Inhalte übersichtlicher.